Desarrollo de software con IA: el método, no la herramienta
La IA ya escribe código; el reto es que escriba el correcto. Cómo estructurar contexto, decisiones y especificación para que implemente lo que necesitas.
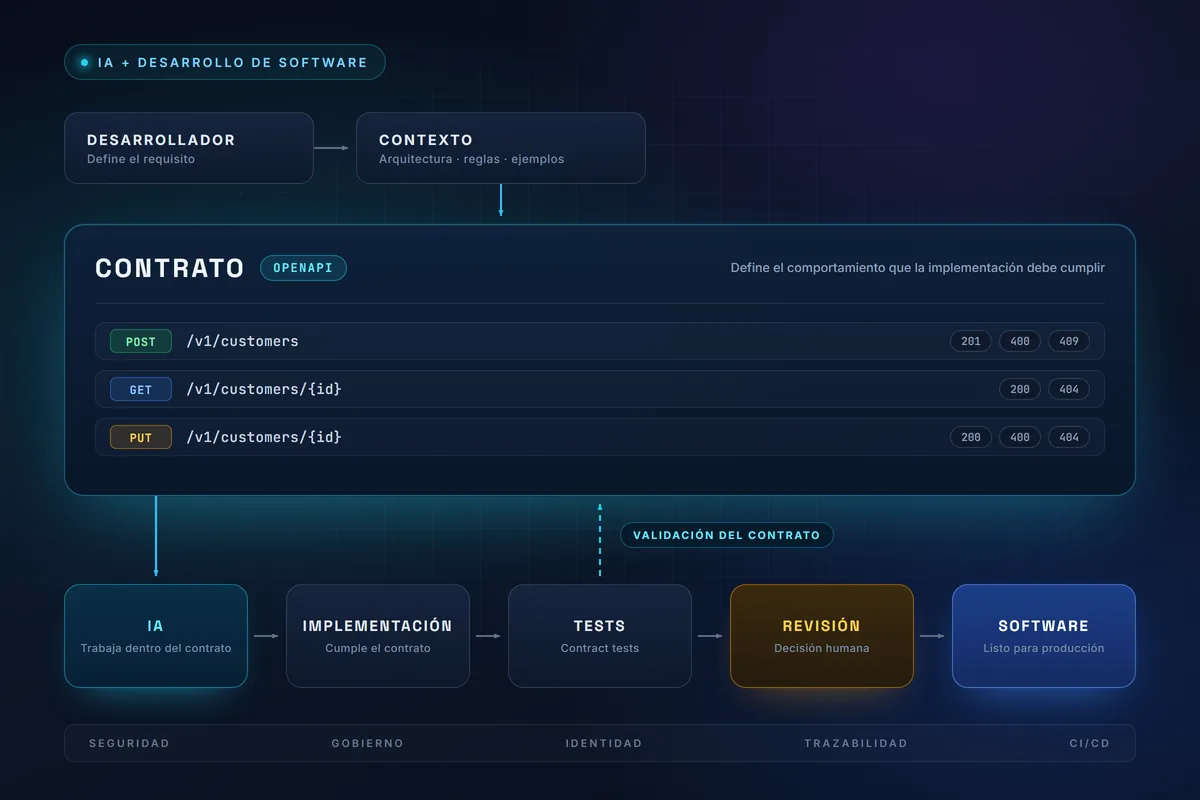
Capítulo 01. La IA ya escribe código. El problema es otro
Si cualquiera puede abrir una IA gratuita y pedirle un controlador, ¿qué sentido tiene que una empresa pague licencias para todo el equipo? La respuesta explica bastante bien qué está cambiando de verdad en el desarrollo de software.
Llevo tiempo viendo la misma escena en proyectos distintos. Alguien pide un endpoint nuevo, la herramienta lo escribe en veinte segundos, el código compila, los tests pasan, y aun así el cambio está mal: devuelve un campo con otro nombre, trata un caso de negocio de una forma que nadie acordó o «arregla» de paso algo de lo que dependía otro equipo.
El código no era malo. Era un código perfectamente razonable para un requisito que nadie llegó a escribir.
Eso es lo que ha cambiado. Durante veinte años el cuello de botella fue teclear: convertir una idea clara en clases, métodos y consultas costaba tiempo, y por eso casi toda la ingeniería de software se organizó alrededor de producir código con menos errores. Hoy esa parte se ha abaratado muchísimo. Controladores, DTOs, tests, refactorizaciones mecánicas, SQL, configuración: todo eso se genera en minutos.
Dónde estaba el cuello de botella y dónde está ahora
Comparación entre Antes y Ahora
Antes
- El desarrollador interpretaba el requisito mientras escribía.
- Las decisiones que faltaban se tomaban sobre la marcha, con criterio acumulado.
- Escribir era lento, así que había tiempo de sobra para pensar mientras se escribía.
- Revisar costaba menos que producir.
Ahora
- Producir es casi instantáneo, y el criterio acumulado ya no se aplica por el camino.
- Las decisiones que faltan las rellena el modelo, en silencio y de forma plausible.
- Pensar ya no ocurre «mientras se escribe»: o pasa antes, o no pasa.
- Revisar cuesta mucho más que producir, y esa asimetría es el problema nuevo.
El trabajo no ha desaparecido: se ha desplazado de escribir el código a decidir qué código hay que escribir.
Cuando escribir cuesta poco, la pregunta interesante deja de ser cómo consigo que genere más rápido y pasa a ser cómo sabe esta herramienta qué tiene que implementar. Y la respuesta honesta, en la mayoría de equipos, es: lo deduce. De un ticket de tres líneas, del código que tiene alrededor y de lo que estadísticamente suele hacerse en proyectos parecidos.
A veces acierta. Cuando falla, no falla de forma escandalosa: falla de forma razonable, que es mucho peor, porque nadie lo nota en la revisión.
Este artículo va sobre cómo se cierra ese hueco. Qué es lo que hay que tener escrito antes de generar nada, por qué las empresas están pagando por herramientas que en apariencia hacen lo mismo que una IA gratuita, y por qué comprar las licencias sin cambiar el método deja casi todo el valor sobre la mesa.
Capítulo 02. Por qué una empresa paga por esto
La pregunta se plantea en casi todos los comités: si existen herramientas gratuitas que escriben código igual de bien, ¿qué se está comprando exactamente? No se compra el modelo. Se compra dónde vive.
Un desarrollador con una IA gratuita en otra pestaña resuelve su problema. Una organización con quinientos desarrolladores haciendo eso tiene cinco problemas distintos, y ninguno es la calidad del código.
No sabe qué código ha salido de la empresa. No puede retirar el acceso a quien se va. No puede aplicar una convención a todo el equipo. No tiene ni un registro de lo que ha pasado. Y el resultado del trabajo entra en el repositorio por copiar y pegar, sin pasar por ningún sitio donde alguien pueda revisarlo con criterio.
| Lo que una empresa necesita resolver | Qué pasa con una herramienta genérica | Qué aporta una solución integrada |
|---|---|---|
| Que el código no salga del perímetro | Cada persona decide qué pega en un chat. Nadie sabe qué se ha compartido. | Acuerdos contractuales sobre tratamiento y retención, y exclusión de rutas o repositorios concretos. |
| Saber quién tiene acceso y retirarlo | Cuentas personales, fuera del directorio corporativo. | Las mismas identidades, grupos y políticas que ya administra la organización. |
| Que la herramienta conozca el proyecto | Hay que pegar el contexto a mano en cada conversación, y se pierde al cerrarla. | Lee el repositorio: código, convenciones e instrucciones versionadas junto al código. |
| Que el trabajo entre por el proceso de siempre | El resultado llega por copiar y pegar, sin trazabilidad. | Desemboca en un pull request, con protección de rama, revisión obligatoria y CI. |
| Poder auditar qué ocurrió | No hay registro. Lo que pasó en el chat se queda en el chat. | Registros de actividad y datos de uso integrables con la auditoría corporativa. |
Visto así, la comparación «Copilot frente a una IA gratuita» está mal planteada. No se comparan dos generadores de código: se compara un generador de código con una capa integrada donde ya vive el trabajo —editor, repositorio, pull request, identidades—. Por eso la decisión suele tomarla el responsable de plataforma y no el equipo que va a programar.
Y por eso el argumento a favor de una herramienta concreta siempre es contextual. Para quien ya trabaja sobre GitHub, Copilot reduce superficie: menos sistemas, menos cuentas, menos sitios por donde algo puede escaparse. Si tu código vive en otra plataforma, buena parte de esa ventaja desaparece y hay que rehacer la comparación con los mismos criterios. No hay respuesta universal, y desconfía de quien te la dé.
La herramienta es una condición necesaria y no es la parte difícil. La parte difícil es el método, y esa no viene en la licencia.
Capítulo 03. Copilot no es el método
El error más extendido no es técnico. Es usar una plataforma pensada para integrarse en un proceso de ingeniería como si fuera un chat con autocompletado, y esperar resultados distintos de los de un chat.
«Créame este endpoint.» «Refactoriza esta clase.» «Genera los tests.» «Arregla este error.»
Son las cuatro peticiones que concentran casi todo el uso real, y las cuatro comparten el mismo defecto: describen una tarea, no un comportamiento. No dicen qué debe pasar cuando el correo ya existe, ni qué se devuelve si no hay resultados, ni cuál de las tres formas de manejar errores que conviven en el proyecto es la buena.
La herramienta necesita esas respuestas para escribir la primera línea, así que se las da ella. Y ahí aparecen tres fallos que cualquiera que haya metido IA en un equipo reconoce al instante.
| Cómo se manifiesta | Por qué pasa | Cuándo lo descubres |
|---|---|---|
| Rellena un hueco con algo que suena bien | Faltaba información y el modelo no distingue entre lo que sabe y lo que deduce. Lo afirma todo con el mismo tono. | En aceptación, o en producción. Nunca en la revisión, porque es razonable. |
| Una suposición se convierte en verdad | Una deducción de la primera conversación se repite en las siguientes y acaba citada como si alguien la hubiera verificado. | Cuando ya hay tres decisiones apoyadas encima y nadie recuerda de dónde salió. |
| Mejora algo que nadie pidió | Ve un patrón que parece un defecto y lo corrige de paso. A veces ese defecto era el comportamiento del que dependía un cliente. | Cuando llama el cliente. |
Fíjate en la tercera columna. Ninguno de los tres se detecta en el momento, y ninguno se arregla escribiendo instrucciones más largas o eligiendo un modelo mejor. Son fallos de información ausente, no de capacidad: la herramienta no podía saber lo que nadie había escrito.
Dos formas de trabajar con la misma herramienta
Comparación entre Como un chat en el IDE y Dentro de un método
Como un chat en el IDE
- Le llega un ticket resumido en una frase.
- El comportamiento esperado nunca se escribe: se negocia dentro de la conversación y se pierde.
- Los tests se generan a partir del código recién escrito, así que confirman lo que ese código hace.
- La revisión mira estilo, porque no hay nada contra lo que contrastar el comportamiento.
Dentro de un método
- Le llegan los artefactos del proyecto: qué existe hoy, qué se decidió y qué debe hacer.
- El comportamiento esperado está escrito y aprobado antes de generar nada.
- Los tests derivan de esa especificación, así que pueden fallar aunque el código sea coherente consigo mismo.
- La revisión compara el cambio con algo acordado.
Misma herramienta, mismo modelo, mismo día. Lo único que cambia es qué había escrito antes de invocarla.
La conclusión práctica es poco glamurosa: el trabajo importante ocurre antes de abrir el editor. Y como ese trabajo consiste en escribir cosas —qué hay, qué decidimos, qué debe hacer— el método que mejor funciona es sorprendentemente parecido a documentar bien. Con una diferencia de peso: ahora la documentación tiene un lector que la usa de verdad.
Capítulo 04. El método documental
Cuatro capas, cada una con un verbo propio, y la regla de que ninguna puede hacer el trabajo de otra. Suena a burocracia hasta que ves los errores concretos que evita.
La idea de fondo es una sola: el código es la consecuencia de algo que se decidió antes, no el sitio donde se decide. Lo que sigue es cómo se estructura ese «antes» para que una herramienta pueda trabajar con él.
La cadena
Diagrama de flujo: AS-IS → Decisiones → Spec → Implementación → Tests → Revisión
- AS-IS Qué hay hoy, verificado sobre el código
- Decisiones Qué elegimos y por qué
- Spec Qué comportamiento se espera
- Implementación Aquí entra la IA
- Tests Derivados de la spec, no del código
- Revisión La aceptación es humana
AS-IS · qué existe hoy
Antes de pedir un cambio hay que saber qué se está cambiando. Parece obvio y casi nunca está escrito: qué hace ese endpoint, quién lo llama, qué comportamiento raro tiene y desde cuándo, qué pasa si dejamos de devolver ese campo.
La regla que hace útil esta capa es separar lo que se ha verificado de lo que se supone. «Este servicio no se usa» es una conclusión; «no he encontrado quién lo llama» es una observación. La primera autoriza a borrarlo, la segunda no. Cuando las dos se escriben igual, alguien acaba borrando algo que sí se usaba.
Decisiones · qué hemos elegido
Aquí viven las decisiones de arquitectura y las restricciones: qué stack, qué patrón de errores, qué no se toca, qué requiere aprobación. Son los ADR de toda la vida y cualquier formato sirve, siempre que cada decisión diga entre qué alternativas se eligió y qué consecuencias acepta.
La restricción más rentable de escribir es casi siempre la de alcance: qué entra en este cambio y qué no. Es la que evita la «mejora de oportunidad», que es el fallo más caro de los tres de la sección anterior.
Spec · qué debe hacer
Es la capa que convierte una intención en algo comprobable. «El usuario debe poder consultar sus vuelos» es un requisito y no sirve para generar nada: no dice qué pasa si no tiene vuelos, si los cancelados cuentan ni cómo se ordenan.
La prueba para saber si algo está especificado es simple: ¿puedo escribir un test que falle si esto no se cumple? Si no puedo, sigue siendo un requisito.
Implementación, tests y revisión
Aquí entra la herramienta, y llega con el trabajo hecho: sabe qué existe, qué se decidió y qué tiene que hacer. Su tarea deja de ser interpretar y pasa a ser construir.
Con los tests hay un matiz que decide su valor. Un test escrito a partir del código recién generado describe lo que ese código hace, y pasa igual si el comportamiento es correcto que si es incorrecto de forma consistente. Para que un test informe de algo, el comportamiento esperado tiene que venir de fuera del código: de la spec, del contrato o de un caso de aceptación acordado. La pregunta útil al revisar un test generado no es si pasa, sino qué defecto concreto lo haría fallar.
Las cuatro capas, y por qué no se mezclan
| Capa | Responde a | Y no puede |
|---|---|---|
| AS-IS · describe | ¿Qué hace hoy el sistema? ¿De qué depende? ¿Qué hay que conservar? | Decidir. Ni siquiera sugerir que algo debería cambiar. |
| Decisión · decide | ¿Qué hemos elegido, entre qué alternativas y con qué consecuencias? | Bajar al detalle del comportamiento. Eso es la capa siguiente. |
| Spec · especifica | ¿Qué comportamiento observable debe tener el sistema cuando esté hecho? | Tomar decisiones de arquitectura ni inventar funcionalidad no pedida. |
| Código · obedece | ¿Cómo se construye? | Reinterpretar ninguna de las tres capas anteriores. |
El ejemplo que mejor explica por qué esto importa: en un proyecto, el análisis documentó que una clase de auditoría heredaba métodos de escritura. Si esa observación hubiera pasado directa a especificación, el sistema nuevo habría implementado altas que nadie invoca. La separación obligó a preguntar si había evidencia de que alguien las llamara. No la había. Una supuesta funcionalidad se convirtió en una restricción de solo lectura. Método heredado no es lo mismo que funcionalidad.
Capítulo 05. Cómo se materializa esto en un repositorio
Nada de lo anterior funciona si vive en la cabeza de quien lleva años en el proyecto, ni en un prompt que alguien escribe bien un martes. Tiene que estar en ficheros.
La diferencia entre explicar la arquitectura en un chat y tenerla escrita en el repositorio no es de comodidad. Un contexto versionado tiene tres propiedades que uno conversacional no puede tener: se revisa en un pull request, así que su calidad se discute como se discute el código; aplica a todo el equipo, en vez de depender de quién escribió el prompt; y evoluciona con el proyecto, así que cuando una convención cambia se corrige en un sitio.
Qué recibe la IA
No un prompt gigante. Los artefactos que el proyecto ya debería tener:
- El documento de arquitectura, que dice dónde va cada pieza.
- Las decisiones y restricciones vigentes: qué está decidido, qué no se toca y qué requiere aprobación.
- La spec del cambio, con los casos raros incluidos.
- El contrato, cuando hay una API de por medio.
- Un caso de uso ya resuelto. Es el contexto más eficaz por volumen: un ejemplo bueno ahorra páginas de descripción.
- Los tests existentes, que muestran qué se considera correcto aquí.
En un repositorio de GitHub esto se traduce en rutas concretas. Las instrucciones
generales viven en .github/copilot-instructions.md; las que solo aplican a
determinadas rutas, en .github/instructions/*.instructions.md con un campo
applyTo que las activa por patrón. Existe además el convenio
AGENTS.md, que varias herramientas leen y permite escribir las reglas una
sola vez sin atarlas a un proveedor.
---
applyTo: "src/main/java/**/infrastructure/rest/**"
---

# Adaptadores REST

- El contrato vive en `resources/openapi/customers.yaml` y es la
  especificación: si el código y el contrato divergen, el defecto
  está en el código.
- No se añaden endpoints que el contrato no declare.
- No se devuelven entidades de persistencia.
- Los errores se traducen en el `@RestControllerAdvice` a las
  respuestas declaradas. No se inventan códigos de estado.
- `OrderController` es la referencia de estilo para este paquete.
Es corto a propósito. Hace tres cosas que ningún prompt hace igual de bien: declara cuál es la fuente de verdad y en qué dirección se resuelve un conflicto, prohíbe comportamientos concretos en lugar de describir un ideal, y señala un ejemplo dentro del propio repositorio.
La regla que evita que esto se convierta en burocracia
Hay un modo de fallo que aparece justo cuando un equipo se toma esto en serio: documentación que crece más rápido que el conocimiento. Las señales son reconocibles: la misma regla redactada de tres formas en tres ficheros, documentos que nadie ha leído desde que se escribieron, un cambio trivial que obliga a tocar cinco ficheros de instrucciones.
La contramedida es escribir cada restricción una sola vez, en el sitio más general donde sea cierta. Y que las reglas prescriban una acción, no una virtud: «no cuentes de memoria, obtén los recuentos buscando en el código» sirve; «sé riguroso» no sirve para nada, porque no se puede verificar.
Capítulo 06. El mismo ticket, de las dos maneras
«Añadir alta de clientes.» Cinco palabras en un tablero. Vamos a recorrerlo primero como se hace normalmente y después con el método, para ver dónde se separan los dos caminos.
Dos recorridos para el mismo ticket
Comparación entre Como se hace normalmente y Con el método
Como se hace normalmente
- Ticket: «añadir alta de clientes».
- El desarrollador interpreta lo que falta y se lo pasa a la herramienta resumido.
- Sale un controlador, un servicio y un repositorio. Compila.
- Se generan los tests a partir de ese código. Pasan.
- Pull request. Se aprueba: está bien escrito.
Con el método
- Ticket: «añadir alta de clientes».
- AS-IS: no existe el recurso; hay un patrón de errores ya establecido en el proyecto.
- Decisión: el correo es único por cliente. Alcance: solo alta.
- Spec y contrato: tres respuestas posibles, escritas y aprobadas.
- La herramienta implementa eso. Los tests validan contra el contrato. La revisión compara con la spec.
En la columna izquierda nadie decidió que el correo fuera único. Simplemente no salió el tema, y el código que se aprobó permite duplicados.
Lo que se escribe antes
La especificación de un cambio así cabe en media pantalla. No hace falta más.
## Alta de cliente

- Con nombre y correo válidos se crea un cliente con identificador
  propio y se devuelve **201**.
- Si faltan campos o el correo no tiene formato válido, **400**.
- Si el correo ya pertenece a otro cliente, **409** y no se crea nada.

Fuera de alcance: modificación y baja de clientes.
Pendiente de decisión: si el correo se normaliza antes de comparar.
Dos detalles que parecen menores y no lo son. «Fuera de alcance» es lo
que evita que aparezcan de regalo un PUT y un DELETE que
nadie pidió. Y «pendiente de decisión» es la regla de escape en
acción: la normalización del correo es una decisión de producto con consecuencias, así
que se marca en lugar de resolverse en el editor.
Como es una API, ese comportamiento se concreta además en el contrato:
paths:
  /v1/customers:
    post:
      operationId: createCustomer
      requestBody:
        required: true
        content:
          application/json:
            schema:
              $ref: "#/components/schemas/CustomerRequest"
      responses:
        "201":
          content:
            application/json:
              schema:
                $ref: "#/components/schemas/CustomerResponse"
        "400": { $ref: "#/components/responses/BadRequest" }
        "409": { $ref: "#/components/responses/Conflict" }
Lo que hace la herramienta
Con eso delante, la petición deja de ser «créame una API de clientes» y pasa a ser implementar un contrato conocido siguiendo las convenciones del paquete. La herramienta ya no elige nombres de campo, ni códigos de estado, ni la forma del error: todo eso venía dado. Genera el controlador, el servicio de dominio y el manejador de excepciones.
@RestControllerAdvice
class CustomerExceptionHandler {

    /** El 409 del contrato. Sin esto, el conflicto saldría como 500. */
    @ExceptionHandler(EmailAlreadyRegisteredException.class)
    ResponseEntity<ProblemDetail> onDuplicate(EmailAlreadyRegisteredException ex) {

        ProblemDetail problem = ProblemDetail.forStatusAndDetail(
            HttpStatus.CONFLICT,
            "El correo ya pertenece a otro cliente"
        );

        problem.setProperty("field", "email");

        return ResponseEntity.status(HttpStatus.CONFLICT).body(problem);
    }
}
Ese manejador es el sitio donde más veces se pierde la conformidad, y merece la pena
entender por qué. Si nadie traduce la excepción de dominio, sale como
500. El contrato decía 409. El código compila, los tests de
servicio pasan, y el consumidor recibe un error de servidor ante una situación de
negocio perfectamente prevista —que además va a reintentar, porque un 500
parece transitorio—.
Nada de eso lo detecta el compilador. Lo detecta un test que valide la respuesta contra
el contrato, que es distinto de un test de integración: el de integración comprueba que
las piezas funcionan juntas y pasaría igual aunque el servicio devolviera
customerId donde el contrato promete id. Herramientas como
swagger-request-validator hacen esa comprobación sobre las peticiones y
respuestas reales del servicio.
Capítulo 07. Agentes especializados y revisión humana
Cuando el contexto está escrito, el trabajo se puede repartir. La tentación es construir un agente que lo haga todo; funciona en demostraciones y se degrada en proyectos reales.
El problema del agente que lo hace todo es que mezcla observar con decidir. Analiza el sistema, y en el mismo paso concluye qué hay que hacer con él. Cuando eso ocurre no queda constancia de cuál de las dos cosas estaba haciendo, y una deducción razonable del análisis reaparece dos pasos después citada como hecho verificado.
Separar por roles no es una preferencia organizativa. Es lo que permite que una afirmación tenga un origen comprobable, y que cada paso se pueda verificar por separado.
El reparto
Diagrama por capas: Análisis (Qué hay hoy, De qué depende, Qué riesgos tiene); Especificación (Spec del cambio, Contrato, Criterios de aceptación); Persona (Aprobación); Ejecución (Implementación, Tests, Migraciones); Revisión (Revisión automática, Revisión humana)
Todos trabajan sobre el mismo material —el de la sección anterior— y eso es lo que hace que el reparto funcione. Sin contexto compartido, cuatro agentes especializados son cuatro fuentes de interpretaciones distintas.
Dos límites merecen estar escritos. Una condición de parada: qué hacer cuando falta un requisito previo —decirlo y detenerse—, porque el comportamiento por defecto es improvisar el paso que falta. Y un límite de alcance: «refactoriza lo que veas mal por el camino» produce diffs que nadie puede revisar.
Los agentes no se entrenan: se curan
Cuando un agente falla, la reacción instintiva es escribir una regla nueva. Casi siempre es el arreglo equivocado. Si afirmó una cifra falsa, no le faltaba disciplina: le faltaba el dato, y hay que añadirlo al contexto. Si propuso una mejora no pedida, sí le faltaba una regla de alcance. Si el agente de análisis editó un fichero, lo que falla es el reparto de tareas.
Escribir una regla donde faltaba contexto engorda las instrucciones sin arreglar nada, y a la larga las vuelve inútiles de puro largas. Merece la pena parar un momento a clasificar el fallo antes de corregirlo.
Qué revisa una persona
La revisión ha cambiado de pregunta. Cuando el código lo escribía una persona, «¿está bien escrito?» discriminaba. Ahora no: el código generado casi siempre está bien escrito. Está mal decidido, que es otra cosa.
Lo que una persona tiene que mirar es el comportamiento frente a lo acordado, el alcance —¿hay aquí algo que nadie pidió?—, el impacto sobre consumidores, la seguridad y si los tests podrían fallar alguna vez. Una primera pasada automática puede resolver lo que no requiere criterio —conformidad con el contrato, análisis de seguridad, dependencias, secretos— y dejar la atención humana para lo que sí.
Capítulo 08. Errores habituales
Seis formas de que esto salga mal. Ninguna es culpa del modelo: todas son de proceso, y todas comparten que en algún punto una decisión que debía ser visible se resolvió en silencio.
| Error | Por qué falla | Cómo lo reconoces en tu equipo |
|---|---|---|
| Repartir licencias y empezar | La herramienta no conoce la arquitectura, las convenciones ni lo que ya se decidió. Lo deduce. | Dos personas resuelven el mismo problema de formas distintas la misma semana. |
| Programar primero y documentar después | La documentación describe la decisión que ya se tomó, así que no puede detectar que fuera equivocada. | El fichero OpenAPI nunca aparece en una revisión: se regenera y se acepta sin mirarlo. |
| Aceptar el cambio porque compila y pasa | Compilar y pasar los tests no dice nada si los tests salieron del mismo código. | Pull requests grandes aprobados en minutos, sin comentarios, de forma sistemática. |
| Pedir «genera todos los tests» | Se prueba la interpretación del modelo, no el comportamiento acordado. La suite queda verde y no informa. | Nadie sabe decir qué defecto concreto haría fallar la suite. |
| Dejar que la IA ajuste el contrato | Convierte un cambio con consecuencias sobre terceros en un efecto secundario de la implementación. | El diff del contrato está en el mismo pull request que lo motivó y nadie externo lo ha visto. |
| «Ya que lo tocamos, arreglamos esto» | Se modifica algo fuera de alcance, a veces un comportamiento del que dependía un cliente. | Diffs de cientos de líneas donde el cambio pedido ocupa veinte. |
Hay un séptimo que aparece justo cuando un equipo hace bien todo lo anterior: medir la mejora por la sensación. Conviene saber que la evidencia sobre productividad es contradictoria. Los experimentos sobre tareas acotadas y proyectos nuevos tienden a mostrar mejoras notables; en cambio, un ensayo controlado sobre desarrolladores expertos trabajando en repositorios grandes que conocían bien midió tiempos de finalización mayores con herramientas de IA, mientras los propios participantes creían haber ido más rápido.
Ese desajuste entre percepción y medición es el dato más útil del conjunto, porque implica que preguntar al equipo no sirve como evidencia. Si vas a justificar la inversión, mide sobre tu propio proceso, con una línea base previa, y cuenta el coste de revisión y de corrección dentro del resultado.
Capítulo 09. El nuevo flujo de desarrollo
Todo lo anterior, en un solo recorrido. Ninguna fase es nueva; lo que cambia es que hay dos puntos donde el proceso se detiene a propósito y varios donde la comprobación es automática.
De ticket a producción
Diagrama de flujo: Ticket → AS-IS → Decisiones → Spec y contrato → Aprobación → Implementación → Tests → Revisión automática → Revisión humana → PR y CI/CD
- Ticket Lo que pide el negocio
- AS-IS Qué existe hoy y de qué depende
- Decisiones Qué elegimos · qué queda fuera de alcance
- Spec y contrato Comportamiento esperado · OpenAPI si hay API
- Aprobación Decisión humana · el ciclo se detiene
- Implementación La IA construye dentro de esos límites
- Tests Derivados de la spec y del contrato
- Revisión automática Conformidad · seguridad · alcance
- Revisión humana Aceptación · el ciclo se detiene
- PR y CI/CD Producción
Falta un paso que no aparece porque no es lineal: el retorno. Cuando la revisión detecta que la herramienta vuelve a equivocarse en lo mismo, lo útil no es corregir ese pull request, sino añadir lo que faltaba al contexto. Un equipo que corrige el mismo problema tres veces en tres revisiones tiene un problema de contexto, no de modelo.
Por dónde empezar
No hace falta montar todo esto de golpe, y montarlo de golpe suele salir mal. El orden que mejor funciona es el inverso al que parece: empezar por donde equivocarse cuesta más caro.
Primero, escribir lo que el equipo ya sabe de memoria: las convenciones, el patrón de errores, cómo se estructura un caso de uso aquí. Es barato y se nota en la primera semana. Después, especificar antes de implementar en los cambios que tocan algo compartido. Y solo entonces los agentes, que sin lo anterior son una forma cara de generar pull requests que nadie puede revisar con criterio.
Lo que realmente separa a unas empresas de otras
Dentro de poco todas las organizaciones tendrán acceso a herramientas equivalentes. Los modelos se alcanzan entre sí en meses y se cambian en un desplegable. Lo que no se cambia en un desplegable es el conocimiento del proyecto estructurado de forma que alguien —o algo— pueda usarlo: qué existe, qué se decidió, qué debe hacer el sistema y cómo se comprueba.
Esa es la parte que pertenece a la empresa, la que no viene en ninguna licencia y la que convierte la IA en algo repetible en lugar de en una sucesión de aciertos individuales. Visto así, la IA no sustituye al proceso de ingeniería: hace que el proceso de ingeniería importe más que antes, porque ahora tiene un consumidor que lo lee literalmente y no rellena los huecos con sentido común.
La IA ya sabe escribir código. Conseguir que escriba el código correcto es un problema de conocimiento, no de modelo.
Puede escribir la implementación. Pero qué debe implementar lo decidimos nosotros, y hay que decidirlo antes.
Si estás intentando meter IA en el ciclo de desarrollo de una plataforma con integraciones vivas, varios equipos y contratos que no se pueden romper, el problema se parece más a uno de arquitectura que a uno de herramientas. Es el tipo de trabajo que abordo en una auditoría técnica: qué conocimiento está escrito y cuál vive solo en la cabeza de tres personas, qué contratos mienten, y en qué orden conviene ordenarlo para que automatizar compense.
Preguntas frecuentes
Las seis dudas que aparecen siempre al plantear esto en un equipo. Cada respuesta es autocontenida: no hace falta haber leído el artículo.
¿Qué es el método documental aplicado al desarrollo con IA?
Es organizar el conocimiento del proyecto en capas separadas para que una herramienta de IA pueda trabajar sobre él sin tener que deducir lo que falta. Las capas son cuatro y cada una tiene un verbo propio: el AS-IS describe qué hace hoy el sistema y de qué depende; las decisiones registran qué se ha elegido, entre qué alternativas y con qué restricciones; la especificación define el comportamiento observable que debe tener el sistema cuando el cambio esté hecho; y el código implementa lo anterior sin reinterpretarlo. La regla que sostiene el método es que ninguna capa puede hacer el trabajo de otra, porque es lo que impide que una observación se convierta en funcionalidad o que una decisión se tome por acumulación de detalles sin que nadie la haya tomado.
¿Por qué pagar por una solución empresarial si existen herramientas de IA gratuitas?
Porque lo que se adquiere no es principalmente la capacidad de generar código, sino su integración con el sitio donde ya vive el proceso de desarrollo. Los factores que suelen decidir son la posibilidad de definir instrucciones y agentes versionados junto al código, que el resultado desemboque en un pull request sujeto a las reglas del repositorio, la administración centralizada de identidades y permisos, la exclusión de rutas o repositorios concretos, los registros de auditoría y los acuerdos contractuales sobre el tratamiento del código. Son atributos de plataforma y de gobierno, no de modelo. Conviene evaluarlos con preguntas concretas sobre la propia organización en lugar de asumir que una herramienta es superior a otra, porque el encaje depende de dónde viva el código.
¿Basta con comprar licencias de Copilot para mejorar el desarrollo?
No, y es el malentendido más caro. Las licencias resuelven problemas de control —quién accede, qué sale del perímetro, por dónde entra el cambio— pero no resuelven el problema de fondo, que es cómo sabe la herramienta qué tiene que implementar. Una organización que reparte licencias sobre un proceso donde nadie escribe el comportamiento esperado obtiene exactamente lo que tenía antes, generado más deprisa: código basado en una interpretación que nadie ha validado. La herramienta es una condición necesaria y no es la parte difícil; la parte difícil es estructurar el conocimiento del proyecto, y eso no viene incluido en ninguna suscripción.
¿Qué contexto necesita realmente una IA para generar buen código?
Material estructurado y versionado en el repositorio, no un prompt largo. En la práctica hacen falta seis cosas: el documento de arquitectura que dice dónde va cada pieza, las decisiones y restricciones vigentes con lo que no se puede tocar, la especificación del cambio concreto, el contrato de la interfaz cuando hay una API, un caso de uso ya resuelto que sirva de referencia de estilo, y los tests existentes que muestran qué se considera correcto en ese proyecto. La ventaja de que viva en ficheros y no en una conversación es triple: se revisa en un pull request como se revisa el código, aplica a todo el equipo en lugar de depender de quién escribió el prompt, y cuando una convención cambia se corrige en un solo sitio.
¿El contrato OpenAPI es documentación o una especificación que hay que implementar?
Es una especificación que la implementación debe cumplir, y la diferencia determina qué se considera un defecto. Si el contrato se genera a partir de anotaciones del código después de programar, describe lo que la implementación acabó haciendo y no puede detectar ninguna divergencia, porque por construcción siempre coincide. Si el contrato se escribe antes y forma parte de la especificación, una divergencia es un fallo del código que las pruebas pueden detectar antes de desplegar. Definirlo antes compensa sobre todo cuando hay varios consumidores, equipos trabajando en paralelo o integraciones entre organizaciones; en un servicio interno con un único consumidor del mismo equipo la ceremonia puede costar más de lo que ahorra. Lo que no es opcional en ningún caso es que, una vez publicado, el contrato y el código digan lo mismo.
¿Qué debe seguir decidiendo una persona cuando se trabaja con agentes de código?
Todo lo que tenga consecuencias fuera del cambio en curso. En concreto: qué se construye y qué problema resuelve, la arquitectura y las decisiones estructurales, el contrato de las interfaces públicas y cualquier modificación que afecte a consumidores, los criterios de aceptación, las decisiones sobre datos personales y seguridad, y la aprobación final. Un agente puede investigar, proponer, implementar, escribir pruebas, revisar y documentar; lo que no debería hacer es aprobar su propia propuesta ni modificar en silencio una interfaz de la que dependen terceros. La distinción práctica no es entre tareas fáciles y difíciles, sino entre decisiones reversibles dentro del equipo y decisiones que comprometen a alguien más.
Referencias
Fuentes primarias, con indicación de qué respalda cada una y de qué afirmaciones del artículo son hechos documentados, cuáles análisis y cuáles criterio profesional.
| Afirmación | Naturaleza | Base |
|---|---|---|
| Se pueden definir instrucciones por repositorio y por ruta, y agentes versionados junto al código. | Hecho | Documentación oficial de GitHub sobre instrucciones personalizadas y agentes. |
| El trabajo del agente desemboca en una rama y un pull request, sujeto a las reglas del repositorio. | Hecho | Documentación oficial de GitHub sobre el agente de codificación. |
| La evidencia sobre mejora de productividad es contradictoria y depende del perfil y de la madurez del código. | Análisis | Comparación entre los experimentos sobre tareas acotadas y el ensayo de METR sobre desarrolladores expertos en repositorios propios. |
| El cuello de botella se desplaza de escribir código a decidir qué código escribir. | Interpretación | Criterio profesional del autor, coherente con la asimetría entre coste de generación y coste de verificación. |
| La separación entre evidencia, decisión y especificación previene la decisión por acumulación. | Interpretación | Metodología documental aplicada por el autor en programas de modernización. |
Fuentes
- GitHub Docs — Instrucciones personalizadas del repositorio Rutas exactas de copilot-instructions.md y de las instrucciones por patrón. Respalda la sección 5.
- GitHub Docs — Sobre el agente de codificación Funcionamiento, entorno de ejecución y límites declarados. Respalda las secciones 2 y 7.
- GitHub Docs — Administración de Copilot Políticas, exclusión de contenido y registros de auditoría: los mecanismos que evalúa la sección 2.
- AGENTS.md Convenio abierto para describir el proyecto a herramientas de IA sin atarlo a un proveedor.
- OpenAPI Specification Define con precisión qué se puede declarar en un contrato y, por tanto, qué se puede verificar.
- Atlassian swagger-request-validator Validación de peticiones y respuestas contra un contrato OpenAPI, con integración para MockMvc y REST Assured.
- OpenAPI Generator — Generador Spring Generación de interfaces de servidor desde el contrato, para quien quiera llevar el ejemplo de la sección 6 más lejos.
- Becker et al. — Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity (METR) Ensayo aleatorizado sobre desarrolladores expertos en repositorios propios: mayor tiempo de finalización con IA, frente a una percepción de mejora. Alcance limitado a ese perfil y a las herramientas de principios de 2025.
- Peng et al. — The Impact of AI on Developer Productivity: Evidence from GitHub Copilot Experimento controlado sobre una tarea acotada y nueva, con mejora sustancial. Es el extremo opuesto del anterior y describe un escenario distinto.
- DORA — Investigación sobre rendimiento de entrega Marco para medir el proceso de entrega sobre indicadores de resultado en lugar de sobre actividad.
Continúa en este blog
- Arquitectura Hexagonal desde cero Cómo aislar el dominio para que el adaptador REST del ejemplo pueda cambiar sin arrastrar las reglas de negocio.
- AI Act: qué cambia de verdad para las empresas La capa de cumplimiento normativo que acompaña al gobierno de la sección 2.
- Inteligencia Artificial empresarial Adopción de IA en plataformas enterprise: arquitectura, gobierno y cumplimiento.
- Auditoría técnica El servicio que instancia este método sobre una plataforma concreta.

Javier García Pérez
Arquitecto de Software Java freelance · Madrid, España
Más de 15 años diseñando y modernizando plataformas Java críticas en banca, retail, seguros, aerolíneas y administración pública, con proyectos para BBVA, Iberia, Carrefour, Tendam, Ocaso y el Govern de les Illes Balears.
Trabajo a diario con Spring Boot, Quarkus, arquitectura hexagonal, Domain-Driven Design, microservicios event-driven sobre Kafka, AWS, Kubernetes, observabilidad con OpenTelemetry e integración de IA generativa con Spring AI y arquitecturas RAG. Escribo sobre lo que aplico en producción, no sobre teoría.
¿Cuánto del conocimiento de tu plataforma está escrito, y cuánto vive en la cabeza de tres personas?
Es la pregunta que decide si meter IA en tu ciclo de desarrollo va a multiplicar tu capacidad o tu deuda técnica. Una auditoría técnica deja el inventario de lo que está documentado y lo que no, qué contratos mienten sobre lo que hace el código, y un orden de adopción por impacto sobre el riesgo.